이 글에서 다루는 내용: 어떤 테스트 과제였나, 공정 비교 규칙, 세 도구의 실제 결과, 항목별 비교표, 상황별 추천, 배운 것.
먼저, 어떤 과제였나
대상은 USD 비용을 받아 환율을 적용하고 KRW 합계를 내는 함수였습니다. 겉보기엔 단순하지만 숨은 함정이 많은 종류예요 — 0원, 음수(환불 케이스), 아주 큰 값, null 환율(조회 실패), 반올림 경계. 과제는 "이 함수의 단위 테스트를 작성해줘"만 주는 것. 관전 포인트는 명확했습니다 — 커버리지 숫자를 채우느냐, 아니면 실제로 깨질 수 있는 지점을 짚느냐.
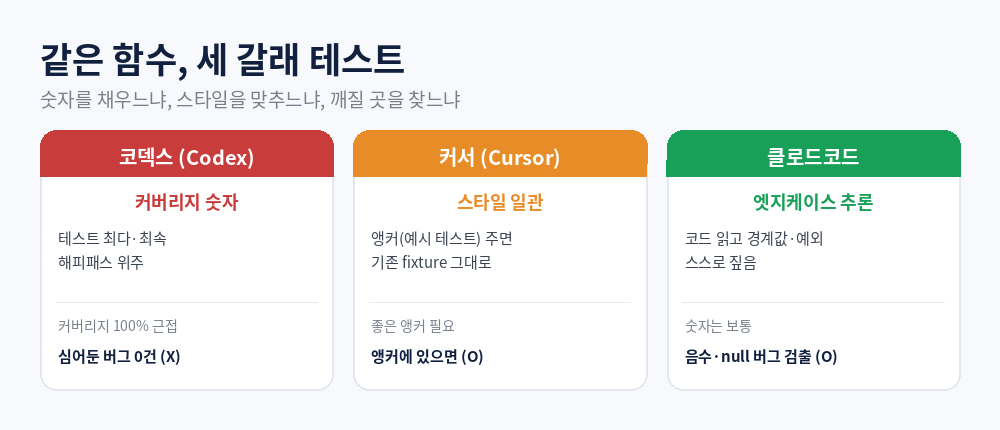
▲ 같은 함수, 세 갈래 테스트. 숫자를 채우느냐, 스타일을 맞추느냐, 깨질 곳을 찾느냐.
공정하게 비교하려고 정한 규칙
① 같은 시작점 — 셋 다 같은 함수, 같은 커밋. ② 같은 프롬프트 — "이 함수의 단위 테스트를 작성해줘"만, 엣지케이스 힌트는 안 줌. ③ 같은 잣대 — 생성된 테스트의 커버리지 %, 그리고 더 중요하게 내가 알고 있던 버그(음수·null 환율)를 잡아내는가, 테스트가 우리 기존 스타일(pytest fixture·given-when-then)을 따르는가. 커버리지는 도구로 측정하고, "버그를 잡느냐"는 일부러 함수에 심어둔 결함으로 검증했습니다.
① 코덱스(Codex): 커버리지는 최고, 버그는 못 잡음
코덱스는 테스트를 가장 많이·빠르게 뽑았습니다. 라인 커버리지가 100%에 근접했고 실행도 다 통과했어요. 문제는 내용이었습니다 — 대부분 해피패스(정상 값 넣고 정상 결과 확인)와 자명한 검증이라, 제가 심어둔 음수 입력·null 환율 버그를 하나도 못 잡았습니다. 커버리지 숫자는 "모든 줄이 실행됐다"만 말할 뿐, "모든 경우가 검증됐다"가 아니니까요.
// 코덱스가 뽑은 전형적 테스트 (해피패스 위주)
test("converts USD to KRW", () => {
  expect(convert(10, 1300)).toBe(13000);
}); // 음수·null·경계값은 없음
맨바닥에서 "일단 테스트 골격을 빠르게 깔고 싶을 때"는 이 속도가 강점입니다. 하지만 테스트의 목적이 버그를 잡는 것이라면, 높은 커버리지 숫자가 오히려 "테스트가 충분하다"는 착각을 줘서 위험할 수 있어요.
② 커서(Cursor): 앵커를 주면 우리 스타일 그대로
커서는 기존 테스트 파일을 @멘션 앵커로 넘기자 진가를 냈습니다 — "@test_pricing.py 이 스타일 그대로 convert 함수 테스트를 작성해줘"라고 하니, 기존 fixture를 재사용하고 given-when-then 주석 구조까지 맞춰서 나왔어요. 인라인 diff로 확인이 편했고요. 다만 앵커(참고 테스트)가 없으면 코덱스처럼 해피패스 위주가 됐습니다 — "좋은 예시 테스트 하나"가 있느냐가 결과를 갈랐습니다.
// 커서: 앵커(@test_pricing.py) 스타일을 그대로 복제
def test_convert_negative_refund(rate_fixture):
    # given-when-then, 기존 fixture 재사용 (앵커 스타일)
    assert convert(-10, rate_fixture) == -13000
테스트가 아예 없는 프로젝트라면 첫 테스트 하나를 공들여 만들고 그걸 앵커로 확장하는 방식이 좋습니다. 관례를 Rules에 넣어두면 앵커 없이도 스타일이 유지되고요.
③ 클로드코드(Claude Code): 엣지케이스를 스스로 짚었다
클로드코드에는 앵커 없이 함수만 줬는데, 코드를 읽고 "여기서 깨질 수 있다"를 추론했습니다 — 음수 입력, null 환율, 0, 아주 큰 값, 반올림 경계를 각각 테스트로 만들었고, 그중 음수와 null 환율 테스트가 실제로 실패하며 제가 심어둔 버그를 드러냈어요. 커버리지 숫자는 코덱스보다 오히려 낮게 나온 케이스도 있었지만, 버그를 잡은 건 이쪽뿐이었습니다. 지난 디버깅 편의 "코드를 깊이 읽는" 강점이 테스트에서도 그대로 나온 셈입니다.
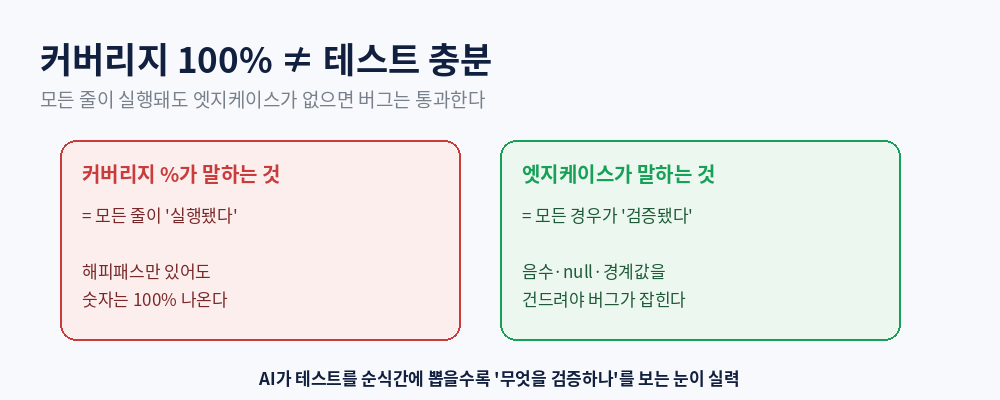
▲ 커버리지 100%가 "테스트 충분"이 아닙니다. 모든 줄이 실행돼도 엣지케이스가 없으면 버그는 통과합니다.
대가는 역시 토큰과 속도였습니다 — 코드를 읽고 위험 지점을 추론하느라 코덱스보다 느리고 소모가 컸어요. 하지만 "테스트를 왜 짜는가"가 버그를 잡기 위해서라면, 그 값을 하는 유일한 결과물이었습니다.
항목별 비교
| 항목 | 코덱스(Codex) | 커서(Cursor) | 클로드코드(Claude Code) |
|---|---|---|---|
| 속도·양 | 가장 빠름·많음 | 빠름 | 느림(추론) |
| 커버리지 숫자 | 최고(100% 근접) | 앵커 따라 높음 | 보통 |
| 엣지케이스 | 거의 없음(해피패스) | 앵커에 있으면 반영 | 스스로 짚음 |
| 심어둔 버그 검출 | 0건 | 앵커에 유사 케이스 있으면 | 음수·null 검출 |
| 스타일 일관성 | 제네릭 | 앵커로 정확 | 양호(코드 관례 추론) |
| 이대로 신뢰? | ❌ (숫자만 높음) | ⭕ (좋은 앵커 필요) | ⭕ (검수 후) |
상황별 추천
테스트 골격을 빠르게 깔고 싶을 때(양이 우선): 코덱스가 빠릅니다 — 단, 엣지케이스는 사람이 따로 추가한다는 전제로. 기존 테스트 스타일을 지키며 확장할 때: 커서에 좋은 예시 테스트를 앵커로 주면 가장 일관됩니다. 버그를 잡는 게 목적일 때(엣지케이스가 핵심): 클로드코드의 추론이 값을 합니다. 저는 요즘 코덱스로 골격을 빠르게 깔고 → 클로드코드에 "엣지케이스만 보강해줘"로 넘기는 2단 구성을 씁니다 — 속도와 깊이를 둘 다 가져가는 방법이에요. 커버리지 %보다 무엇이 중요한지는 이 글에 단일 도구 관점으로 따로 정리해뒀습니다.
정작 제일 크게 배운 것
세 도구를 가른 건 "테스트를 얼마나 짜느냐"가 아니라 "무엇을 검증하느냐"였습니다. 코덱스의 100% 커버리지가 버그를 하나도 못 잡은 게 이 시리즈에서 가장 인상적인 장면이었어요 — 커버리지 %는 안심을 주지만 안전을 주지 않습니다. AI가 테스트를 순식간에 뽑아줄수록, "이 테스트가 실제로 깨질 곳을 건드리는가"를 사람이 확인하는 눈이 더 중요해집니다. 리뷰 4편(디버깅·스캐폴딩·리팩토링·테스트)이 결국 같은 자리에 도착했네요 — 빨라질수록 검수가 실력입니다.
자주 묻는 질문 (FAQ)
Q. 테스트 생성엔 어떤 도구가 제일 낫나요?
A. 목적에 따라 다릅니다. 커버리지 숫자·양이면 코덱스, 기존 스타일 유지면 커서(앵커 필요), 버그를 잡는 엣지케이스면 클로드코드입니다. 실전에선 코덱스로 골격을 깔고 클로드코드로 엣지케이스를 보강하는 2단 구성이 효율적이었습니다.
Q. 커버리지 100%면 테스트가 충분한 거 아닌가요?
A. 아닙니다. 커버리지는 "모든 줄이 실행됐다"만 뜻하고 "모든 경우가 검증됐다"가 아닙니다. 이번에도 커버리지 100%에 가까운 테스트가 음수·null 같은 엣지케이스 버그를 하나도 못 잡았습니다.
Q. AI가 만든 테스트를 그냥 믿어도 되나요?
A. 특히 테스트는 안 됩니다. 얕은 테스트는 "테스트가 있다"는 착각만 주고 버그는 통과시킵니다. 최소한 알고 있는 실패 케이스(경계값·예외)를 AI 테스트가 잡는지 확인하고 채택하세요.
Q. 테스트가 아예 없는 프로젝트는 어디서 시작하나요?
A. 첫 테스트 파일 하나를 fixture·네이밍·given-when-then까지 공들여 만들고, 그걸 앵커로 커서에 확장시키는 방식이 좋습니다. 그 뒤 엣지케이스는 클로드코드로 보강하세요.
한눈에 보는 요약
같은 함수에 테스트를 세 도구에 시켰더니 — 코덱스는 커버리지 최고지만 버그 0건, 커서는 앵커를 주면 스타일 그대로, 클로드코드는 엣지케이스를 스스로 짚어 유일하게 버그를 잡았습니다. 양은 코덱스, 스타일은 커서, 버그 검출은 클로드코드. 그리고 커버리지 %는 품질이 아니라는 것 — 실전에선 코덱스로 깔고 클로드코드로 보강하는 2단이 답이었습니다.
함께 보면 좋은 글
같은 버그, 세 도구에 다 시켜봤다 (디버깅 편)
같은 리팩토링, 세 도구에 다 시켰다 (리팩토링 편)
Cursor로 테스트 자동 생성하기 (커버리지보다 중요한 것)
참고 자료
Claude Code 공식 문서
OpenAI Codex 소개
Cursor 공식 사이트
'AI 코딩 일반' 카테고리의 다른 글
| 커서 vs 클로드코드 vs 코덱스: 작업별로 뭘 써야 하나 총정리 (디버깅·만들기·리팩토링·테스트·리뷰, 2026) (0) | 2026.09.16 |
|---|---|
| 같은 PR, 커서 Bugbot·클로드코드·코덱스에 리뷰시켰다: 뭘 잡고 뭘 놓치나 (2026) (0) | 2026.09.15 |
| 같은 리팩토링, 커서·클로드코드·코덱스에 다 시켰다: 광범위 수정 실전 비교 (2026) (0) | 2026.09.10 |
| 같은 기능, 커서·클로드코드·코덱스에 다 만들게 시켰다: 스캐폴딩 실전 비교 (2026) (0) | 2026.09.10 |
| 같은 버그, 커서·클로드코드·코덱스에 다 시켜봤다: 디버깅 실전 비교 (2026) (0) | 2026.09.08 |