이 글에서 다루는 내용: 어떤 PR이었나, 공정 비교 규칙, 세 도구의 리뷰 결과, 항목별 비교표, 상황별 추천, 배운 것.
먼저, 어떤 PR이었나
대상은 통화 환산 유틸을 공용 함수로 통합한 PR이었습니다(지난 리팩토링 편에서 다룬 그 작업의 실제 PR). 리뷰 도구의 검출력을 보려고 세 가지 결함을 일부러 심었어요 — ① 음수 입력 검증 누락(환불 케이스에서 오작동), ② 사용자 입력을 그대로 쓰는 보안 이슈(검증 없이 파싱), ③ 반올림 경계의 미묘한 로직 버그. 관전 포인트는 "이 셋을 각각 잡느냐, 아니면 스타일 지적만 하고 넘어가느냐"였습니다.
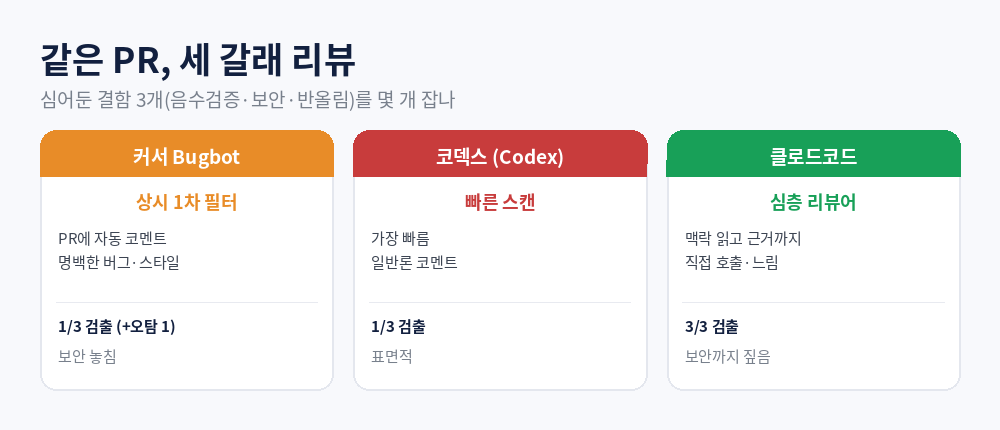
▲ 같은 PR, 세 갈래 리뷰. 상시 1차 필터냐, 빠른 스캔이냐, 맥락을 읽는 심층이냐.
공정하게 비교하려고 정한 규칙
① 같은 PR — 셋 다 같은 diff. ② 같은 요청 — "이 PR을 리뷰해줘"만, 심어둔 결함 힌트는 안 줌. ③ 같은 잣대 — 심어둔 세 결함을 몇 개 잡는가, 오탐(잘못된 지적)이 얼마나 나오는가, 리뷰가 실행 가능한(actionable) 코멘트인가, 그리고 비용·워크플로. 사람이 이미 아는 결함으로 채점하니 "리뷰가 진짜인지 스타일 훈수인지"가 바로 드러납니다.
① 커서 Bugbot: PR에 붙는 빠른 1차 필터
Bugbot의 강점은 워크플로였습니다 — PR을 올리면 자동으로 GitHub에 리뷰 코멘트가 달려서, 내가 부르지 않아도 1차 점검이 됩니다. 명백한 버그(반올림 경계)와 스타일 이슈를 빠르게 짚었어요. 다만 보안 이슈(입력 검증 누락)는 놓쳤고, 오탐도 한 건 있었습니다("이 변수 안 쓰임" — 실제론 쓰임). 리뷰당 과금($1~1.5, PR 클수록 비쌈)이라 모든 PR에 자동으로 돌리면 티끌이 쌓이므로, 일정 규모 이상 PR에만 트리거하는 규칙이 필요합니다.
② 코덱스: 빠르지만 표면적
코덱스도 PR 리뷰를 지원하는데, 가장 빨랐지만 가장 얕았습니다. 심어둔 셋 중 반올림 버그 하나만 잡고, 음수 검증·보안은 넘어갔어요. 코멘트도 "이 부분을 확인하세요" 수준의 일반론이 많아 바로 고칠 수 있는(actionable) 지적은 적었습니다. 여러 PR을 빠르게 훑어 "큰 문제 없나" 보는 용도엔 맞지만, 리뷰를 이걸로 끝내면 위험합니다.
// 세 도구가 잡은 결함 (심어둔 3개 중)
// Bugbot:   반올림 버그 O / 음수검증 X / 보안 X  (+오탐 1)
// Codex:    반올림 버그 O / 음수검증 X / 보안 X
// ClaudeCode: 반올림 O / 음수검증 O / 보안 O
③ 클로드코드: 맥락을 읽어 보안까지 짚었다
클로드코드에는 로컬에서 "이 변경을 리뷰해줘"라고 시켰는데, 코드베이스 맥락을 읽어 세 결함을 모두 짚었습니다. 특히 입력 검증 누락을 "보안 이슈"로 분류하고 "이 값이 사용자 입력에서 온다면 검증이 필요하다"며 근거까지 달았어요 — 지난 보안 스캔 후기에서 본 깊이가 리뷰에서도 나온 셈입니다. 대가는 역시 느리고 토큰을 많이 쓰며, PR에 자동으로 붙지 않아 내가 직접 불러야 한다는 점. "상시 자동"이 아니라 "중요 PR에 부르는 심층 리뷰어"에 가깝습니다.
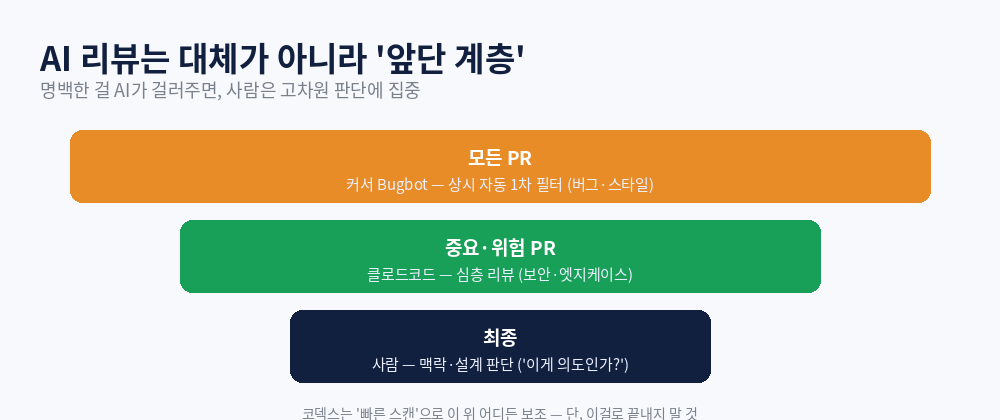
▲ AI 리뷰는 사람을 대체하는 게 아니라 앞단에 까는 계층입니다.
항목별 비교
| 항목 | 커서 Bugbot | 코덱스(Codex) | 클로드코드 |
|---|---|---|---|
| 워크플로 | PR에 자동 코멘트 | 클라우드 PR 리뷰 | 로컬, 직접 호출 |
| 심어둔 결함 검출 | 1/3 (+오탐) | 1/3 | 3/3 |
| 보안 이슈 | 놓침 | 놓침 | 짚음(근거까지) |
| 코멘트 실행가능성 | 중간 | 낮음(일반론) | 높음 |
| 속도·비용 | 빠름·PR당 과금 | 가장 빠름 | 느림·토큰↑ |
| 포지션 | 상시 1차 필터 | 빠른 스캔 | 심층 리뷰어 |
상황별 추천
모든 PR에 상시 1차 점검을 깔고 싶을 때: Bugbot이 워크플로상 최적입니다 — 자동으로 붙으니까(단, 트리거 규칙으로 비용 관리). 중요하거나 위험한 PR을 깊게 보고 싶을 때: 클로드코드에 직접 리뷰를 시키세요 — 보안·엣지케이스까지 잡습니다. 여러 PR을 빠르게 훑어 큰 문제만 거르고 싶을 때: 코덱스가 빠릅니다(단, 이걸로 리뷰를 끝내지 말 것). 저는 Bugbot을 상시 1차 필터로 깔고, 결제·보안·마이그레이션 관련 PR만 클로드코드로 심층 리뷰하는 2단 구성을 씁니다. AI 코드 리뷰 도구 전반 비교는 이 글에 따로 있습니다.
정작 제일 크게 배운 것
세 도구 중 무엇도 사람 리뷰를 대체하지 못했습니다 — 가장 깊었던 클로드코드조차 "이건 의도된 동작인가?"라는 맥락 판단은 못 했으니까요. AI 코드 리뷰의 진짜 값은 사람이 봐야 할 것을 줄여주는 1차 필터에 있습니다. 명백한 것들을 AI가 걸러주면, 사람은 "이 설계가 맞나" 같은 고차원 판단에 집중할 수 있죠. 리뷰 5편을 오면서 계속 같은 결론에 도달했는데, 코드 리뷰 편에서 그게 가장 선명해졌어요 — AI는 검수를 대신하는 게 아니라, 검수를 잘하게 도와주는 도구입니다.
자주 묻는 질문 (FAQ)
Q. AI 코드 리뷰가 사람 리뷰를 대체하나요?
A. 아니요. 명백한 버그·스타일·일부 보안 이슈를 앞단에서 걸러주는 1차 필터입니다. "이게 의도된 동작인가", "이 설계가 맞나" 같은 맥락 판단은 여전히 사람 몫이라, AI 리뷰 위에 사람 리뷰를 얹는 계층 구성이 맞습니다.
Q. 코드 리뷰엔 어떤 도구가 제일 낫나요?
A. 용도에 따라 다릅니다. 모든 PR 상시 1차 점검은 Bugbot(자동), 중요·위험 PR 심층 리뷰는 클로드코드(보안·엣지케이스), 빠른 스캔은 코덱스입니다. Bugbot 1차 + 중요 PR만 클로드코드 심층의 2단이 효율적이었습니다.
Q. Bugbot을 모든 PR에 돌리면 비용이 괜찮나요?
A. 리뷰당 과금이라 PR이 많으면 쌓입니다. 일정 규모(예: 50줄) 이상 PR에만 트리거하는 규칙을 걸면 지출을 절반 가까이 줄일 수 있습니다.
Q. AI 리뷰 코멘트를 그대로 반영해도 되나요?
A. 오탐이 섞입니다(이번에도 "안 쓰이는 변수" 오탐이 있었습니다). 코멘트를 참고로 받아들이되 실제 코드로 확인하고 반영하세요. 반복되는 오탐은 규칙·설정에 피드백하면 노이즈가 줄어듭니다.
한눈에 보는 요약
같은 PR을 세 도구에 리뷰시켰더니 — Bugbot은 PR에 자동으로 붙는 빠른 1차 필터(깊이는 얕고 오탐 약간), 코덱스는 가장 빠르지만 표면적, 클로드코드는 맥락을 읽어 보안·엣지케이스까지 유일하게 짚음. 상시 1차는 Bugbot, 심층은 클로드코드, 빠른 스캔은 코덱스. 그리고 셋 다 사람 리뷰의 대체가 아니라 앞단 필터입니다.
함께 보면 좋은 글
AI 코드 리뷰 도구 비교 (Bugbot·Copilot·CodeRabbit)
같은 리팩토링, 세 도구에 다 시켰다 (리팩토링 편)
같은 함수, 세 도구에 테스트 짜게 시켰다 (테스트 편)
참고 자료
Claude Code 공식 문서
Cursor 공식 사이트 (Bugbot)
OpenAI Codex 소개
'AI 코딩 일반' 카테고리의 다른 글
| AI 에이전트한테 시켰다가 날린 시간들: 삽질 부검 3건 (실측 후기) (0) | 2026.09.18 |
|---|---|
| 커서 vs 클로드코드 vs 코덱스: 작업별로 뭘 써야 하나 총정리 (디버깅·만들기·리팩토링·테스트·리뷰, 2026) (0) | 2026.09.16 |
| 같은 함수, 커서·클로드코드·코덱스에 테스트 짜게 시켰다: 커버리지 vs 엣지케이스 (2026) (0) | 2026.09.12 |
| 같은 리팩토링, 커서·클로드코드·코덱스에 다 시켰다: 광범위 수정 실전 비교 (2026) (0) | 2026.09.10 |
| 같은 기능, 커서·클로드코드·코덱스에 다 만들게 시켰다: 스캐폴딩 실전 비교 (2026) (0) | 2026.09.10 |